21 de febrero de 2014

Resumen de Trabajos Relacionados Relevantes

Investigación
Semana 5

La quinta reunión con mi asesora de tesis la lleve a cabo en línea el 14 de Febrero del 2014 donde se dio revisión a mi avance de tesis de acuerdo a lo contemplado para la semana, se sugirieron algunas modificaciones para los archivos de LaTeX, se sugirió tratar de completar los primeros capítulos por completo, y por último se explicó de forma general la tarea con que habría de cumplir para esta semana.

Tareas realizadas

De forma general las tareas realizadas fueron las que se listan a continuación:
  • Corrección de errores en el documento de tesis.
  • Creación de una matriz comparativa de características con los trabajos relacionados.
  • Explicación breve de estos trabajos relacionados.
  • Explicación de las características para el nuestro trabajo de tesis.
  • Avance de código en el modulo de servicio web.

Resumen de trabajos relacionados relevantes

En la sección de matriz de características dentro de mi tesis agregue los trabajos que tienen mayor similitud en ciertos aspectos en comparación con el trabajo que estoy desarrollando.

Se creó una tabla que en sus columnas muestra características de los trabajos, y por cada fila se evalúa a alguno de los trabajos relacionados relevantes.

Se marcó con una "paloma" aquellos que si cumplen con la característica, con una "cruz" los que no, y con un "asterisco" aquellos que cumplen parcialmente.

Prueba de procesamiento a través del servicio web

Como prueba de concepto se añadió un método que se encarga de ejecutar el script de python con una imagen de prueba almacenada previamente en el servidor, la cual será procesada para obtener el texto encontrado en la misma y posteriormente desplegar el resultado en la página web.


Avances para la siguiente semana

  • Diseño de la solución propuesta.
  • Terminar el contenido de los primeros capítulos.
  • Crear diccionario de palabras y evaluar el porcentaje de texto recuperado en comparación con el original.

14 de febrero de 2014

Búsqueda y Clasificación de Trabajos Relacionados

Investigación
Semana 4

La cuarta reunión con mi asesora de tesis la lleve a cabo en línea el 7 de Febrero del 2014 donde se dio revisión a mi avance de tesis de acuerdo a lo contemplado para la semana, se sugirieron algunas modificaciones para los archivos de LaTeX, hubo algunos consejos generales en cuanto a la extensión que deben de llevar los textos a lo largo de todo el trabajo de tesis, y por último se explicó de forma general la tarea con que habría de cumplir para esta semana.

Tareas realizadas

De forma general las tareas realizadas fueron las que se listan a continuación:
  • Corrección de errores en el documento de tesis.
  • Búsqueda de trabajos relacionados con mi tesis.
  • Explicación de cada trabajo relacionado encontrado con su respectiva cita.
  • Avance de código para el modulo de servicio web.

Búsqueda de trabajos relacionados

En la sección de trabajos relacionados dentro de mi tesis agregue los trabajos encontrados divididos en algunas subsecciones de acuerdo a la temática de cada uno. Para la búsqueda de trabajos relacionados utilice algunos buscadores/servicios como Google Scholar, ACM Digital Library, ScienceDirect, IEEE Xplore y Springer Link donde encontré gran cantidad de información de artículos y algunos libros, de los cuales algunos es posible la descarga de forma gratuita, pero esto depende de la red a donde estés conectado, por ejemplo dentro la red de la universidad es posible acceder de forma gratuita a muchos de los mismos, cumpliendo la condición de que los mismos sean para uso personal y con fines de investigación.

Para lograr encontrar los trabajos relacionados fue necesario hacer búsquedas con palabras claves, las cuales pudieran arrojar un buen listado de artículos y/o libros similares a la temática de mi tesis. Entre las palabras/frases que usé para esta búsqueda se encuentran las siguientes:
  • ocr
  • text recognition
  • image processing for text recognition
  • analysis of text information
  • information analysis
  • text analysis
Encontré un total de 15 trabajos relacionados, veamos algunos de estos:
  • Data Management And Analysis Methods
    Gery W. Ryan and H. Russell Bernard
  • A method for text localization and recognition in real-world images
    Lukas Neumann and Jiri Matas
  • Untangling Text Data Mining
    Marti A. Hearst
  • Speech and Text-Image Processing in Documents
    Marcia A. Bush
  • Robust Pre-processing Techniques for OCR Applications on Mobile Devices
    Loh Zhi Chang
  • Language-support System Using Character Recognition
    Kikuo Asai
  • Effective Text Extraction and Recognition for WWW Images
    Jun Sun
  • Information Retrieval and OCR: From Converting Content to Grasping Meaning
    Jamie Callan
Para cada uno de los anteriores y de los faltantes en esta lista, se escribió una pequeña explicación de que temática abordan y por qué estos están relacionados a mi trabajo.

Creación de una API para obtención de datos

Usando el framework Ruby on Rails cree una API sencilla que se encarga de recuperar datos almacenados en una base de datos, y los devuelve en formato JSON.

En pocas palabras para esta API se hace llamar a una URL, tal y como se puede hacer con AJAX de Javascript desde el navegador, y esta regresa como contenido información estructurada en su formato JSON, el cual después puede ser utilizado para un posterior procesamiento o simplemente mostrar esta información por algún medio.

La siguiente imagen muestra como se ve el resultado para la consulta de un producto con el ID 2.


Cuando se intenta consultar una URL de un producto el cual no existe en la base de datos se muestra un mensaje de error.


También se puede acceder a toda la lista de productos de una sola vez.


Los datos fueron agregados para la prueba por medio de formularios básicos. Se muestra la vista web donde esta el listado de los productos y las opciones de eliminar, editar y visualizar.


Avances para la siguiente semana

  • Resumen de trabajos relacionados relevantes.
  • Corrección de errores y avance de más textos dentro de la tesis.
  • Mejorar la detección de texto en imágenes siguiendo las sugerencias proporcionadas por la comunidad de OCR.

7 de febrero de 2014

Identificación y Estructuración de Antecedentes

Investigación
Semana 3

La tercera reunión con mi asesora de tesis la lleve a cabo el 30 de Enero del 2014 desde el CIIDIT donde se dio la revisión al trabajo realizado en la semana anterior, así como explicación de las tareas generales a realizar para la semana tres. Nuevamente hubo sugerencias y correcciones por hacer en el documento de mi tesis, esta vez se mencionó todo lo necesario en cuanto código de LaTeX que había que agregar para poder continuar con el capítulo de antecedentes.

Tareas generales realizadas

  • Fue necesario cambiar a quién estaba contemplado como coasesor de tesis debido a que esta persona era externa a la facultad, y decidí colocar como un revisor más a la Dra. Sara Elena Garza Villarreal, quién forma parte del grupo de investigadores involucrados en el proyecto de toma de decisiones ecológicas, en el cual participo de manera voluntaria.
  • Se agregaron dos comandos para aplicar colores a ciertos textos en el documento de LaTeX con el fin de resaltar aquellos contenidos que están pendientes de revisión o que aún se trabaja en corregir algunos textos.
  • El orden de algunas secciones dentro de los capítulos fueron cambiados, con el fin de que todo lleve una secuencia lógica y entendible, como el caso de la introducción donde ahora los motivos y justificación serán mencionados antes de iniciar con la hipótesis y objetivos del proyecto.
  • Se añadieron los archivos necesarios y faltantes para la inclusión de la bibliografía al final del documento.
  • También se hizo una reestructuración más "limpia" de la carpeta con todos los contenidos, ya que eran muchos archivos que se mezclaban con los autogenerados por LaTeX.
  • Se creó un script de bash simple para automatizar la generación del pdf de salida, ya que siempre había que ejecutar los mismos comandos una y otra vez cada que se quería ver el resultado.

Identificación de antecedentes

Para el capítulo de antecedentes se buscaron aquellos temas y conceptos de los cuales hay que tener conocimiento previo para lograr entender completamente que es lo que se esta realizando y desarrollando junto con el trabajo de tesis.

Debido a que hay que contemplar todo aquello que puede no ser de conocimiento general, se listaron algunos conceptos y definiciones de palabras que seguramente todo aquel que esta involucrado con temas de tecnología y desarrollo de software son de uso cotidiano.

Entre algunos de los conceptos que incluí fueron pixel, resolución y filtro, que si bien parecen muy simples, es necesario definirlos para evitar confusión al lector.

Módulo básico para análisis de información

En cuanto a código esta semana trabajé en un módulo encargado únicamente de procesar información básica que se puede encontrar en la etiqueta o empaque de un producto. Entre la información clave será necesario identificar:
  • Lugar de origen.
  • Empresa quien elabora el producto.
  • Información de contacto.
  • Información nutrimental/ingredientes o material con que se fabrica.
  • Información que previene al consumidor de cierta acción o uso del producto.
  • Etcétera.

Por el momento hice pruebas para detección de lugar en base a un diccionario de lugares conocidos.

También se hizo una prueba para reconocer si un texto parece ser positivo o negativo, con el fin de estar preparados en su momento para un módulo que busque tuits relacionados al uso de un producto y conocer si la impresión es positiva o negativa.

El programa tiene incluido una serie de lineas de texto con la información a analizar.
fragments = [
    "Nueva Wal-Mart de Mexico",
    "PEPSI-COLA",
    "COCA-COLA",
    "Smart product",
    "Tastes horrible",
    "the 28th of december",
    "the ticket is 212-323-1239",
    "from Mexico",
    "number 1 800 567-4321",
    "costs $23 per person",
    "website http://theevent.com",
    "some comments at #coolevent",
    "David david32@gmail.com"
]
La ejecución de prueba resulto como se ve a continuación.
memories:research ramongonzalez$ python language_processor.py 
mexico is a known place
<<Nueva Wal-Mart de Mexico>> contains a place
****************************
smart is positive word
so <<Smart product>> is a positive text
****************************
horribleis negative word
so <<Tastes horrible>> is a negative text
****************************
mexico is a known place
<<from Mexico>> contains a place
****************************
<<some comments at #coolevent>> has a hashtag
****************************
memories:research ramongonzalez$
Para tener una idea de a donde se puede llegar con la implementación de este módulo, analicé el funcionamiento de esta herramienta creada en Javascript, que es un acercamiento a un procesador de lenguaje natural, el cual identifica información proveniente de un texto.

Esta herramienta se encuentra disponible en Knwl.js.

La meta será llegar a tener algo muy parecido implementado en Python. Mientras tanto el código implementado se encuentra en el repositorio.

Trabajo por realizar

  • Mejorar los textos redactados hasta el momento y ampliar algunos contenidos.
  • Continuar con el escrito de los antecedentes en donde solo se mencionó la referencia bibliográfica.
  • Iniciar con la creación del modelo encargado de la escritura en una base de datos.
  • Prueba de una API sencilla de donde se pueda consultar información almacenada en el servidor.
  • Investigar sobre proyectos y trabajos relacionados.

30 de enero de 2014

Hipótesis y Objetivo

Investigación
Semana 2

La segunda reunión con mi asesora de tesis la llevé a cabo el 17 de Enero del 2014 desde el Starbucks sucursal Anáhuac donde recibí retroalimentación de los avances generados para la primer semana. Hubo sugerencias y correcciones por hacer en el documento de mi tesis, tal como cambiar los títulos en algunas de mis secciones, ser consistente con el uso de mayúsculas en los títulos, entre otras cosas.

Hipótesis

En lo que respecta a la segunda semana en la creación de mi tesis, se inició con las posibles hipótesis de las cuáles habrá que elegir alguna para determinar el camino a seguir en el desarrollo del proyecto. Se me pidió que antes de iniciar a escribir mi propia hipótesis leyera algunas cuantas hipótesis de otras personas, para conocer como otros redactan su hipótesis.

Entre las tesis en donde revise algunas hipótesis fueron de los alumnos anteriormente asesorados por Elisa Schaeffer. La razón por la cuál estas hipótesis me parecieron adecuadas fue debido a que estas están relacionadas a dar solución a un problema relacionado con el software.

En forma muy general lo que se redacta en la hipótesis está basado en la formación de una pregunta que se puede responder como un si o no. Es decir, se redacta el estado actual en que se encuentra alguna solución a un problema y se plantea un método con el que es posible hacer alguna mejora a lo ya existente, el cual en el resto de la tesis nos encargaremos de determinar si la solución se puede dar o no.

Las hipótesis que yo planteo para mi tesis son las siguientes, la marcada en negritas es la que más me gusta a mi, y las otras son también alternativas.
  • Es posible mediante el uso de técnicas de visión computacional procesar la información de la etiqueta de un producto, por ejemplo una caja de cereal o algún producto de limpieza, con el fin de ayudar a la persona a tomar decisiones inteligentes que apoyen en la selección de productos nutritivos y ecológicos.
  • Con ayuda del procesamiento de texto mediante visión computacional es posible ayudar a la gente a darse cuenta de si algún ingrediente esta o no presente en el producto que pretende comprar y alertar al consumidor de posibles riesgos de salud en caso de que estos ingredientes estén considerados como dañinos. Por ejemplo algunos productos de consumo diario contienen ingredientes que no todas las personas pueden asimilar bien como el caso de la Fenilalanina presente en los chicles.
  • Mediante el uso de técnicas de visión computacional es posible procesar, estructurar y analizar los textos que se encuentran en los empaques de productos en un tiempo suficientemente rápido que una persona usando un dispositivo móvil percibe como instantáneo.

Objetivo

En los objetivos siempre se escribe lo que se va a realizar y parten de la pregunta principal y de las preguntas subsecuentes se escriben los objetivos particulares.

En la reunión se me explicó que de forma general para redactar los objetivos, la oración se debe iniciar con un verbo que implique la acción que se desprende de cada una de las preguntas.

Objetivo general
En mi caso particular escribí algunos objetivos que independientemente de la hipótesis que se decida tomar son aplicables al desarrollo de mi proyecto.
  • Desarrollar una herramienta de software para reconocimiento de texto haciendo uso de un módulo de reconocimiento óptico de caracteres mejorado con técnicas de visión computacional y que esta herramienta este disponible mediante una interfaz de programación de aplicaciones a través de un servicio web.
  • Proporcionar una interfaz de programación de aplicaciones disponible mediante peticiones a un servicio en línea que envíe la foto tomada al empaque de un producto a un servidor y esta sea procesada para estructurar la información, guardarla y regresar un resultado en un lapso tiempo que se perciba como "instantáneo".
  • Garantizar que la herramienta de software funcione sin problema alguno en cualquier ambiente de desarrollo siempre y cuando permita hacer peticiones a un servidor mediante HTTP, ya sea desde un dispositivo móvil o un navegador web.
Objetivos específicos
  • Crear un módulo para reconocimiento de texto.
  • Crear un módulo para preprocesar la imagen u aplicar filtros.
  • Crear un módulo para procesamiento de información.
  • Desarrollar una API para obtención de datos.

Aplicación de filtros para el preprocesamiento de la imagen

Esta semana instalé OpenCV para procesar la imagen con técnicas de visión computacional. El proceso de instalación me tomó tiempo debido a que era la primera vez que lo hacía en Mac OS X, y tuve problemas con la instalación con Homebrew (instalador de paquetes), por lo que decidí que todo lo que instale de módulos de Python lo haré desde MacPorts, con el cuál fue más fácil resolver problemas que tenía con el otro instalador de paquetes.

El avance en código en la semana fue el uso de OpenCV desde Python para aplicar algunos filtros a la imagen antes de intentar extraer el texto.

Se probó con la foto de una etiqueta del envase de un refresco. La siguiente imagen es la captura original.


Con esta imagen al mandarla directamente a la herramienta para procesar el texto se obtenía lo siguiente.

’ , . 1"» ‘
: LN Avg .. . .......- .a., _
mo EN msxnco won maorsunoonts
AUTOMZADOS BAJO ucsucm as mswo, mc.
vuacmsz. u.v. szsrousnsu as msmcacrou
PEPSI-COLA MEXICANA, 8. DE R.L DE C.V.. BDSOUE DE
DURAZNOS N0. 67 P150 7, 001.. BOSOUES DE LAS
mmxs, DELEGACION MIGUEL HIDALGU, on moo.
M mace, D.F.
meaenesmtszAcuncnnpounmon.AzocAnss(Al00f;*
vm JARABE as MAIZ), cnnmvmo gmsc .
D0rEnvase7,5.Cantidad urPorcidn.Conten' .
9? Ca‘ (391 kJ); Proteinag 0 0i “'35-” 031:3: 23 a 0‘ "" F00“
Grasa Saturada 0 g~ Carhuhidratos ouspvflgadgo 27 ma {)5
L cualesz Azincares 23”g; Fihra Dietética 0 9«
Como se puede notar el resultado obtenido no es muy bueno, si existe información relevante, pero no la suficiente para hacer un análisis de la misma. Después se probó con aplicar filtros a la imagen antes de pasarla con el módulo de procesamiento de texto y la imagen obtenida con filtros es la siguiente.


Al aplicar el reconocimiento de texto se obtuvo lo siguiente.

nscuo EN Méxuco P08 smaommnonzs
AUTORIZADOS we ucemzm or PEPSICO, ma.
PURCHASE, N.Y. RESPONSABLE DE FABRICACION
PEPSI-COLA MEXICANA. 3. DE Bl. DE C.V.. BDSOUE DE
DURAZNOS N0. 67 PISO 7, COL BOSOUES DE LAS
LQMAS, oaeenmim MIGUEL mouse. on moo.
105 mexsco. o.r.
\NGREDlENTES:AGUACARBONATADA,AZUCARESWUW
Y/0 JARABE DE MAiZ), CARAMELO CLASE
coucmranno PEPSI-COLA. ® PEPSI, PEPSI-COLA YDE
LOGOTIPO ms: sou wumcns nscnsrnaoxzrsw
PEPSH30, mc. consumo PREFERENTE v L%7%E?BESC0.
cumo on ENVASE. coussm/sss EN L
CUKDA EL AMBIENTE RECICLA EL ENVASE .
‘ pomones
‘NFORMACION NUTRIMENTAL: Porcidn 200 EneygétiC0
[ Der Envase 7,5. Cantidad por Porcidn: Cont?!“
' 92 C3‘ (391 kJ); Proteinas 0 g: 033,35 0W;
V Grasa Saturada 0 g; Carbuhidratos DISD0,"'5oaio 27 m9 ea;
Wales: Azucares23 g; Fihra Dietética09~ T _ , ”
{5} 21”‘) <
Lmea . D.F.: 5281 2981 V 5 2004
pegs‘ Interior: 01  !“V'N
Como se puede ver, esta vez es posible recuperar más información que antes, no es perfecta pero hay más información entendible con respecto a la prueba anterior.

Se seguirá mejorando el preprocesamiento con el fin que sea posible crear un módulo que se encargue de aplicar los filtros correctos a la imagen antes de mandarla a la extracción de texto.

Los cambios están en el repositorio.

Fuentes consultadas:
OpenCV - Python

13 de enero de 2014

Planteamiento del Tema y Preparación de la Plantilla

Investigación
Semana 1

Como parte de mi último semestre de la carrera de Ingeniero en Tecnología de Software, tome la decisión de llevar el módulo de Investigación, el cuál consiste en preparar una investigación científica y/o un desarrollo tecnológico que tendrá como producto una tesis de licenciatura, publicaciones en revistas o participación en congresos, supervisados por Elisa Schaeffer.

La primer reunión inicial la lleve a cabo el día 13 de Enero del 2014 desde una sala de juntas dentro del CIIDIT - PIIT. La reunión fue tomada con un grupo de compañeros de carrera, Cecilia, Juan, Rafael, Isaías y Saúl, que también llevan el módulo de Investigación en el mismo semestre que yo.

En esta primer reunión se explicaron los requisitos con los que había que cumplir para poder dar inicio a nuestro proyecto de investigación, el cuál dará como resultado el escrito de una tesis de licenciatura, y se hablo de forma general las tareas que se estará realizando a lo largo del semestre.

Nuestra tesis constará de 3 elementos:
  • Blog (para contribuciones técnicas).
  • Archivos LaTex (en Dropbox compartidos con nuestra asesora).
  • Repositorio Git (para el código implementado).

Como evidencias de trabajo para la primer semana se nos pidió lo siguiente:
  • Enlace al blog y repositorio en línea, y compartir el directorio con nuestra plantilla de tesis (1 punto).
  • Prueba de concepto con código en el repositorio (4 puntos).
  • Creación del esqueleto con secciones para la tesis y escrito que diga lo que deseo hacer de tesis (4 puntos).
  • Reunión final de la primer semana para el viernes 17 de Enero (1 punto).

La liga a mi repositorio es la siguiente: Repositorio GitHub

¿Qué quiero hacer para mi tema de tesis?

Para mi proyecto de tesis quiero realizar un módulo en python usando la librería pytesser y herramienta OCR para el reconocimiento de texto en imágenes, haciendo uso de otras herramientas/librerías complementarias que ayuden a filtrar la imagen a procesar, como OpenCV, con el fin de lograr un mejor resultado en la obtención de información y evitar en lo mínimo el ruido que se puede generar con imágenes borrosas o de no muy alta calidad.

El texto obtenido de la imagen de un producto será analizada y se obtendrá información de utilidad que luego será almacenada y posiblemente enviada de regreso a quién hizo la petición para mostrar un extracto de datos con algún sentido informativo como mostrar la ubicación en donde el producto fue empacado, el prestigio de la marca que elabora el producto, etc.

Se creará una API para consulta de todos los datos almacenados en una BD, esto accesible mediante HTTP y su respectiva seguridad, y enviada a quién hizo la petición en forma de archivos JSON, con el fin de que sean procesados nuevamente o solo mostrarlos en alguna interfaz como dispositivo móvil mediante aplicación Android o iOS, gafas de realidad aumentada o navegadores web.

Toda la parte de backend se podría crear haciendo uso de algún framework MVC, como Ruby on Rails, Django o Laravel, con el fin de facilitar el desarrollo, mantenimiento y mejora del mismo, y todos dando buen resultado en modo producción con una escalabilidad alta en caso de ser necesario.

El aporte que me gustaría realizar es hacer de esto una herramienta o módulo de código libre, que sea fácil de personalizar y adaptar a cualquier otro proyecto con fines parecidos, además de optimizar el tiempo de procesamiento para evitar demoras altas, así como enfocarse en un bajo coste de transferencia de datos entre el servidor y la aplicación que solicita información.

Exploración de trabajos relacionados a mi Tesis

Se hizo una búsqueda de trabajos relacionados a mi propuesta de tesis y encontré algunos proyectos/servicios que ya dan en parte una solución para el reconocimiento de texto.

Los primeros dos son servicios que permiten integrar el reconocimiento de texto a tus proyectos, tienen buen soporte de lenguajes de programación, pero no son totalmente libres ya que es necesario comprar un plan o ajustarse al plan libre pero limitado.

Los otros dos son servicios en línea que no tienen opciones para el desarrollador, y solo son una fuente de consulta en línea.

Prueba del módulo python

Para realizar la prueba de extracción de texto en una imagen se instaló una herramienta para reconocimiento óptico de caracteres llamada tesseract-ocr disponible desde este sitio: tesseract-ocr.

Haciendo uso del módulo Pytesser se realizó una prueba de la utilidad de esta herramienta. Se creo un pequeño programa que recibe una imagen como entrada y usando los métodos ofrecidos por el módulo de python, se observó el resultado generado por el reconocimiento de texto.

En una de las pruebas se uso la siguiente imagen.


Esta imagen generó el resultado mostrado a continuación. Y como se puede apreciar existe algo de ruido en la obtención de texto, pero la parte principal, donde se encuentra la información de valor, fue rescatada correctamente.

c..\R.\N Y CA N" L lxmnmx mu \t‘\_)ll|\\\ «iv In x .-ululmi «iv

% muwum pt mm: (Us tune as nu quedd
sntnstmluo, Wal Mm! de Mmucu Iv
devuolvo N 100% de su dlne!‘0.

HECHO PARA: Nueva Wal-Mart de México, S. de R.L.
de CV. R.F.C. NWM-970924-4W4 ® Marca registrada
propiedad de Wal-Mart Stores, Inc. 702 SW. 8th
Street, 72716-8095 Bentonville, Arkansas, U.S.A.
LICENCIADA A: Wa|—Mart de México, S.A.B. de CV.
USADA BAJO SUBLICENCIA POR: Nueva Wal-Marl: de
México, S. de R.L. de C.V., Nextengo No. 78, Col. Santa

Cruz Acayucan, Del. Azcapotzalco, México, [).F., C.jP,    

HECHO EN MEXICO.

Este programa se irá mejorando usando otras técnicas de visión computacional, con el fin de eliminar el ruido que se puede generar en la imagen, y recuperar el texto sin problema alguno.

Tareas por hacer:
  • Concretar el problema a resolver con mi tesis.
  • Seguir alguna guía de estilo para LaTeX.

28 de mayo de 2013

Compresión de Imágenes

Teoría de la Información y Métodos de Codificación
Tarea 6

Para la última tarea se nos pidió hacer un programa que lograra comprimir imágenes. Este programa no debería de usar funciones explícitas para compresión de imágenes, pero era posible usar paquetes para el manejo de las mismas, así como paquetes adicionales como el de Transformadas de Wavelet.

Ya que había estado usando un poco PyWavelets en otra tarea, me decidí por seguir usando esta herramienta para tratar con imágenes, y en este caso usar la transformada haar para comprimirlas.

Realicé un programa que toma como entrada una imagen en formato PNG, la cuál pasa por una función la cuál aplica las funciones necesarias para comprimirla, y esta es comprimida usando varios umbrales. El valor del umbral mientras más pequeño sea, la imagen no se comprimirá mucho, pero la calidad seguirá siendo casi la misma. Si el valor del umbral es grande, la imagen se logra comprimir mucho más, pero ésta pierde calidad.

Prueba 1


Primero tenemos la imagen original la cual se paso como parámetro desde la terminal. Esta imagen tiene un tamaño de 512x384 pixeles, y un tamaño de archivo de 104.5 KB.


Al ejecutar el programa se puede ir viendo el porcentaje de compresión por cada prueba con diferentes umbrales. AL final de la ejecución se muestra la gráfica de estos datos y se imprime el tiempo promedio de ejecución por cada prueba.


Podemos ver que el tiempo promedio para esta imagen fue de 0.4547. En la siguiente imagen podemos ver la gráfica del porcentaje de compresión logrado con el valor que se dio como umbral.


Mientras mayor sea el umbral, mayor la compresión de la imagen, pero este llega a un punto en el que la compresión ya no cambia tan drásticamente como al inicio.

En las siguientes dos imágenes se puede observar la imagen original en comparación con una de las imágenes resultantes con un umbral indicado en el nombre de la imagen que se ve en el título de la ventana. Abriendo la imagen en pantalla completa es posible notar la pérdida en la calidad de la imagen cuando el umbral aplicado fue mayor.

En la parte inferior de cada imagen es posible ver el tamaño en KBs de la imagen.


Prueba 2


Se realizó la misma prueba pero con una imagen de mayor tamaño en dimensiones y peso. Esta imagen es de 1024x769 pixeles con un tamaño de archivo de 234.7 KB.


Podemos observar que al ser una imagen de mayor resolución, se logro llegar a un porcentaje de compresión mayor que en la imagen anterior.


Y como es de esperarse el tiempo de ejecución aumento aproximadamente cuatro veces en relación con la prueba anterior.


En seguida tenemos también dos comparativas de la imagen original con una de las imágenes comprimidas con un cierto umbral.


Algo que se puede notar para imágenes de dimensiones como la anterior, es que la pérdida en la calidad de la imagen es menos notoria.

Código


El código completo es el siguiente. Esta incluido lo necesario para mostrar al final de la ejecución la gráfica de porcentaje contra valor de umbral.


APIs consultadas:
Discrete Wavelet Transform (DWT)
Python Imaging Library (PIL)

Referencias:
Gleb V. Tcheslavski, "Basic Image Compression Methods", 2008. [En línea]. Disponible en: http://ee.lamar.edu/gleb/dip/08-2%20-%20Image%20compression.pdf

Panrong Xiao, "Image Compression by Wavelet Transform", 2001. [En línea]. Disponible en: http://dc.etsu.edu/cgi/viewcontent.cgi?article=1108&context=etd

26 de mayo de 2013

Aplicación de Redes Sensoras

Redes de Telecomunicaciones
Tarea 8

Nombre del documento:
Deploying a wireless sensor network on an active volcano

Autores:
Geoffrey Werner-Allen, Konrad Lorincz, Matt Welsh, Omar Marcillo, Jeff Johnson, Mario Ruiz y Jonathan Lees

Enlace:
http://ieeexplore.ieee.org/stamp/stamp.jsp?tp=&arnumber=1607983


Introducción


El aumento de peso y necesidad de mayor capacidad para recolección de datos con sensores de red inalámbricos mas pequeños y ligeros, es una tarea que requiere gran desarrollo. Matrices que contienen decenas de sensores de red inalámbricos ahora son posibles, permitiendo nuevos estudios científicos que antes no eran posibles con instrumentos tradicionales.

El diseño de redes de sensores para apoyar los estudios volcánicos requiere abordar las altas tasas de datos y alta fidelidad de los datos que estos estudios demandan. La aplicación de redes de sensores se basa en la detección de eventos y recuperación de datos de manera confiable lo cual demanda un gran ancho de banda y calidad en el envío de los datos.

Redes de sensores inalámbricos, en los que numerosos nodos de recursos limitados están conectados a través de radios de señal inalámbrica de bajo ancho de banda, han sido el foco de una intensa investigación durante los últimos años. Desde su concepción, se han emocionado una variedad de comunidades científicas debido a su potencial para facilitar la adquisición y estudios científicos de datos.


La colaboración entre científicos de la computación y otros científicos han producido redes que pueden grabar datos a una gran escala y cuya resolución no era posible anteriormente. Tomando este progreso a un paso más allá, las redes de sensores inalámbricos potencialmente pueden avanzar en la realización de estudios geofísicos de la actividad volcánica.

El estudio de los volcanes activos suele implicar redes de sensores para la recolección de señales sísmicas y sonidos infrasónicos.

En contraste con el equipo de adquisición de datos volcánica existente, los nodos usados en esta investigación son más pequeños, más ligeros y consumen menos energía. La distribución espacial resultante facilita en gran medida los estudios científicos de los fenómenos de propagación de ondas y los mecanismos de origen volcánico.

Además la solicitud de recolección de datos volcánica presenta numerosos problemas informáticos. El estudio de los volcanes activos requiere alta velocidad en la transmisión de datos, alta fidelidad de los datos y matrices dispersas con alta separación espacial entre los nodos.

La intersección de estas exigencias científicas con las capacidades actuales de nodos de redes de sensores inalámbricos, crea difíciles problemas informáticos que requieren investigación e ingeniería moderna.

Redes de sensores para la vigilancia volcánica


Las redes de sensores inalámbricos pueden ayudar en gran medida a la comunidad geofísica. Una estación de recolección de datos volcánica típica de hoy consiste en un grupo de componentes voluminosos, pesados, con gran demanda de energía que son difíciles de mover y requieren baterías de coche para su abastecimiento.

La adquisición de datos a menudo requiere de vehículos o ayuda de helicópteros para la instalación y mantenimiento del equipo. El almacenamiento local es también un factor limitante, ya que las estaciones suelen registrar datos en una tarjeta de almacenamiento Flash o en unidades de disco duro, las cuales los investigadores deben obtener constantemente, lo que requiere que vuelvan periódicamente a cada estación.


Estas limitaciones hacen que sea difícil desplegar grandes redes de los equipos existentes, tales experimentos a gran escala podrían ayudar a lograr importantes conocimientos sobre funcionamiento interno de volcanes.

La tomografía volcánica, por ejemplo, es un enfoque para el estudio de la estructura del interior de volcanes. Recolección y análisis de señales desde múltiples estaciones puede producir asignaciones precisas del edificio volcánico.

Estudios como estos podrían ayudar a resolver debates sobre los procesos físicos en el movimiento del interior de un volcán. La comunidad geofísica ha establecido herramientas y técnicas que se utilizan para procesar las señales obtenidas por las redes de recolección de datos volcánicas.

Estos métodos analíticos requieren que nuestras redes inalámbricas de sensores proporcionan datos de muy alta fidelidad, ya que una sola muestra perdida o dañada puede invalidar un registro completo. Las pequeñas diferencias en las frecuencias de muestreo entre dos nodos también pueden frustrar el análisis, por lo que las muestras deben estar sincronizadas en tiempo con precisión, para permitir comparaciones entre nodos y entre redes.

La grabación de eventos individuales no responde adecuadamente a todas las preguntas científicas que plantean los vulcanólogos. De hecho, la comprensión de las tendencias a largo plazo requiere de formas de onda completa que abarca largos intervalos de tiempo. Sin embargo, poco ancho de banda en los nodos de sensores inalámbricos los hace inadecuados para este tipo de estudios, por lo que nos hemos centrado en la recopilación de eventos desencadenados en el diseño de nuestra red.

Estudios volcánicos también requieren grandes separaciones entre nodos para obtener puntos de vista muy distantes de las señales sísmicas y de infrasonidos a medida que se propagan. Configuraciones de matriz a menudo comprenden una o más posibles intersecciones de las líneas de sensores, y da como resultado topologías que plantean nuevos retos para el diseño de redes de sensores, dado que gran parte del trabajo anterior se ha centrado en redes densas en el que cada nodo tiene varios vecinos.

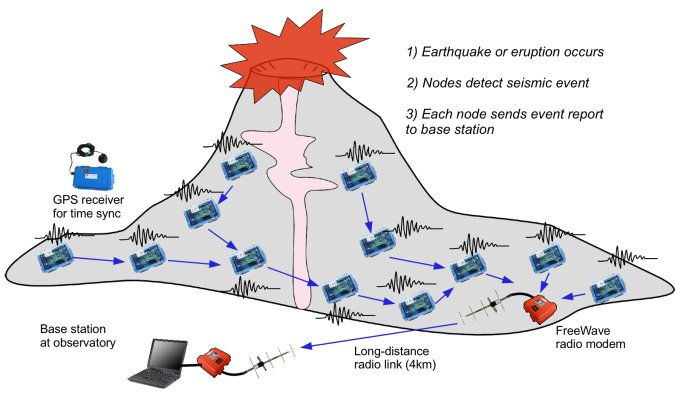
Operación típica de una red


Cada muestra de datos recoge la señal de 2 a 4 canales acústicos a 100 Hz, y almacenando los datos en la memoria flash local. Los nodos también transmiten periódicamente mensajes de estado y llevan a cabo la sincronización de tiempo.

Cuando un nodo detecta un evento interesante, enruta un mensaje a la computadora portátil de la estación base. Si suficientes nodos informan de un caso, en un corto intervalo de tiempo, el ordenador portátil inicia la recolección de datos, que se desarrolla por turnos.


Las descargas desde el ordenador portátil tardan entre 30 y 60 segundos para la adquisición de datos de cada nodo utilizando un protocolo de recogida de datos fiable, asegurando que el sistema recupera todos los datos almacenados en el buffer del evento. Cuando la recolección de los datos se completa, los nodos vuelven a muestrear y almacenar los datos del sensor.

Gran cantidad de datos: altas tasas de detección de eventos y almacenamiento en buffer


Los nodos pueden obtener datos más rápido de lo que pueden transmitirlos.

Simplemente los datos de registro para almacenamiento local para su posterior recuperación es también factible para estas aplicaciones. La memoria flash del dispositivo se llena en unos 20 minutos al grabar dos canales de datos a 100 Hz. Afortunadamente, muchos eventos volcánicos interesantes caben en el buffer.

Durante un terremoto o una explosión típica en el volcán, 60 segundos de datos de cada nodo es adecuado. Cada nodo sensor almacena los datos de la muestra en su memoria flash local, que tratamos como un buffer circular. Cada bloque de datos es una marca de tiempo con la hora del nodo local, que más tarde se asigna a una hora de la red global.

Cada nodo ejecuta un detector de evento en los datos muestreados a nivel local. Buenos algoritmos de detección de eventos producen altas tasas de detección, manteniendo pequeñas tasas de falsos positivos. La sensibilidad del algoritmo de detección que enlaza estos dos métricas, un detector más sensible identifica correctamente más eventos a expensas de producir más falsos positivos.

Cajas del dispositivo sensor y configuración física


Un solo nodo sensor de red, con su tarjeta de interfaz y su soporte de la batería estaban ubicadas en un pequeño estuche resistente a la intemperie y al agua, como se muestra en la imagen. Se instalan conectores ambientales a través de la caja, dejando que se conecten los cables de los sensores externos y las antenas sin tener que abrir la caja y molestar al interior. Para trabajar en condiciones de humedad y arena, estos conectores externos se convirtieron en un gran ventaja.


Ubicación de red y topología


Se instalaron estaciones en una configuración más o menos lineal que irradia lejos de la ventilación del volcán y produjo una abertura de más de tres kilómetros. Se ha tratado de colocar las estaciones tan distantes como las radios de cada nodo lo permita.

A pesar de que las antenas podrían mantener enlaces de radio de más de 400 metros, la geografía en el sitio de implantación requiere en ocasiones la instalación de estaciones adicionales para mantener la conectividad de radio. Otras veces, se desplegaron nodos esperando que se comunique con su vecino inmediato, pero más tarde se observó que estos nodos fueron pasados por alto por sus compañeros más cercanos, en favor de un nodo más cercano a la estación base.


La mayoría de los nodos se comunican con la estación base a través de tres o menos saltos, pero en unos pocos los datos se mueven a través de hasta seis nodos.

Además de los nodos de sensores, se utilizaron varias otras piezas de equipo. Tres radio módems Freewave que proporcionan un enlace de radio fiable a larga distancia entre la red de sensores y el ordenador portátil del observatorio. Cada Freewave requiere una batería de coche para la energía y se recarga con paneles solares. Un pequeño número de nodos de redes de sensores desempeñó papeles secundarios. Una interfaz entre la red y el módem Freewave y otro fue conectado a un receptor GPS para proporcionar una base de tiempo global.

Resultados


El ejemplo de un terremoto típico en la red fue registrado. Mediante el examen de los datos descargados de la red, se verificó que los detectores de eventos locales y globales están funcionando correctamente. Como se ha descrito, se desactivó el muestreo durante la recolección de datos, lo que implica que el sistema no ha podido grabar dos eventos uno tras otro. En algunos casos, esto significa que un pequeño movimiento sísmico desencadenaría la recopilación de datos, y se perdería una gran explosión poco después. Se tiene la intención de volver al enfoque de la detección de eventos y la recopilación de datos para tener esto en cuenta en una próxima mejora al sistema de red de sensores.


Conclusiones


En una buena implementación de redes de sensores inalámbricos es necesario tomar en cuenta varios factores que podrían afectar en la recuperación en tiempo real de datos así como la obtención de datos de alta fidelidad, como lo puede ser la cantidad de nodos en la red, la distancia entre ellos, el radio de transmisión que pueden abarcar cada uno de ellos, además de la duración de la batería que los abastece de energía eléctrica. Pensando en todo esto, es posible establecer cuál es la mejor ubicación para los nodos, con el fin de que estos puedan transferir su información sin errores hasta la estación de monitoreo.

En el caso planteado de la red de sensores inalámbricos en la zona aledaña a un volcán activo, es necesario implementar la detección correcta de datos sobresalientes, ya que por la poca capacidad de los nodos de almacenar y transmitir los datos al mismo tiempo, es posible detectar una pequeña vibración que se tome como dato interesante y que al estarse transmitiendo esta información a la base, ocurra otro acontecimiento de mayor importancia el cual no pueda ser registrado por que el nodo actualmente esta ocupado enviando la información del evento anterior, lo cuál puede provocar la pérdida de información valiosa para la investigación. Mecanismos más avanzados en el almacenamiento de la información pueden ser implementados para evitar esta pérdida de información, tratando de almacenar la información por un periodo más largo de tiempo antes de ser enviados, y de ser posible poder ser procesados para confirmar si es una muestra de datos relevante o no.

Referencia:
Geoffrey Werner-Allen, Konrad Lorincz, Matt Welsh, Omar Marcillo, Jeff Johnson, Mario Ruiz y Jonathan Lees, "Deploying a wireless sensor network on an active volcano", en Sensor-Network Applications, 2006, pp. 18-25.